OKHK 👀

币安称黑客通过虚假工作面试入侵工程师笔记本电脑
#安全
币安官方博客披露了黑客如何窃取价值 63 亿美元加密货币的初步调查报告。报告称,攻击始于今年六月: 2026 年 6 月——供应链攻击。钱包开发运维团队的工程师 A 为安装一款热门 AI 编程工具,通过搜索引擎查找并下载了一个遭篡改的 Homebrew 安装程序。我们的安全团队主动检测到了这一异常,更换了该设备,同时轮换了所有相关凭证。尽管如此,工程师 A 的岗位信息,以及其钱包基础设施团队中的相关同事信息,仍已暴露给攻击者。
9月——社会工程攻击。软件工程师 B 通过一个正规的求职平台,收到了一名冒充项目总监人员的联系。工程师B在该平台上的个人资料中提及了自己在币安的工作经历。对方以项目总监的身份安排了第一轮面试,由一名人力资源代表参与;随后又安排了第二轮面试,面试者自称是该虚构公司的 CEO。
在第一轮面试中,冒充人力资源代表的人员与工程师B进行了实时视频面试。为了建立信任,面试者还向工程师B分享了自己的社交媒体账号,其平台帐号有个人生活照片和视频。这种方式比以往的社会工程攻击手段更复杂,也更具欺骗性。
第二轮面试通过一款热门社交聊天应用进行。面试接近尾声时,工程师B被要求将一份含代码仓库的“作业”下载到工作电脑中。该代码仓库包含恶意代码,在安装过程中便会执行,进而触发了一系列未经授权的操作。
该恶意软件采用了复杂的代码混淆和规避检测技术,包括用恶意版本替换某个正规开发工具组件,以执行命令并与攻击者控制的外部服务器建立通信。当时,终端安全防护工具未能检测到这一零日恶意软件。攻击者还采取了隐藏恶意行为、清除入侵痕迹等措施,进一步增加了检测和后续调查的难度。
10 月 20 日——利用内部 AI 工具作为攻击跳板。攻击者利用遭入侵的工程师 B 的电脑,通过内部 AI 工具控制了钱包开发运维工程师 A,以及另一名钱包软件工程师 C 的设备。攻击者很快发现,工程师 A 的电脑上存有一个具有容器部署权限的令牌。
10 月 30 日——渗透钱包签名操作。10 月 30 日 01:15 至 03:56(东八区时间)期间,攻击者登录了软件工程师 C 的电脑,使用从工程师 A 处窃取的凭证部署了一个容器,并执行恶意脚本,进而发起此次攻击。
https://www.binance.com/zh-CN/blog/%E7%A4%BE%E5%8C%BA/3229153443759566763


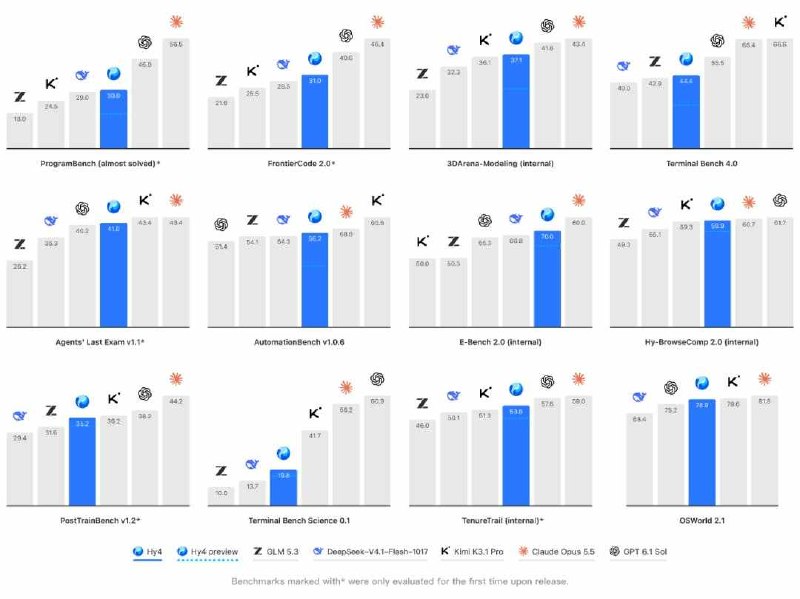
腾讯Hy4正式版发布,综合表现已跻身最强开源模型之列
腾讯混元发布 Hy4 正式版。相比 8 月的 Preview,进一步扩大了预训练和后训练规模,提升编程、长程 Agent、金融分析等能力,并首次加入视觉理解和电脑操作。腾讯公布的多项评测显示,其综合表现已进入开源模型第一梯队。
Hy4 现在可以结合屏幕画面、鼠标键盘和命令行操作电脑,完成跨软件任务。腾讯为此搭建了部署数百款软件的沙箱,让模型反复练习并验证结果。游戏开发方面,GameDev 和 GameLogic 评测较 Preview 分别提升 19.1% 和 9.8%。
科研任务也有新进展。腾讯称,Hy4 在无人干预下,用 1.5 小时完成了近 700 万个细胞的小鼠胚胎三维重建;还能自主定位模型训练系统的性能瓶颈,将内部测试中的训练吞吐提升 20.1%。
正式版维持 Preview 的 API 定价,腾讯云标准 API 调用在 12 月 31 日前限时五折,Token Plan 订阅在 11 月 18 日前享积分消耗 2.5 折。模型已上线腾讯云、OpenRouter 等平台,权重计划近期开源。
信源
动察 Beating 频道 · 动察 Beating 交流群
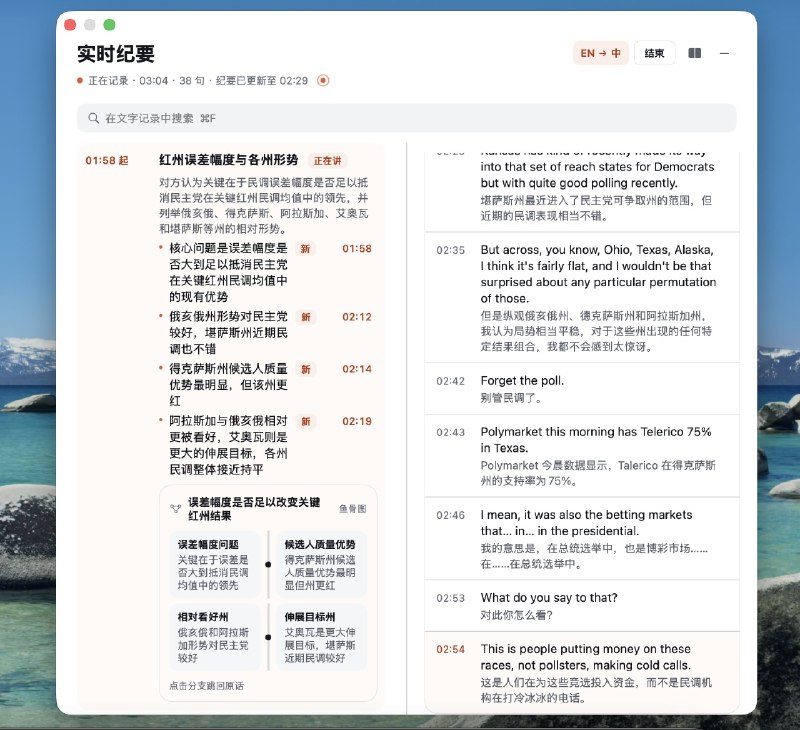
知了 · Cicada - Mac 上的实时纪要、双语文字记录、字幕与同声传译。
REA 逆向飞书会议纪要,功能比原版更强大,客户端已💯开源,模型💯免费,商用魔改无限制👇
Github:https://github.com/wquguru/cicada
官网直达:https://cicada.indaloop.app/
模型直达:https://chat.ant-ling.com/platform/api
支持:腾讯会议、飞书会议、钉钉会议、企业微信会议、Zoom、Google Meet、Microsoft Teams、Webex、X Spaces、Discord 语音频道、Telegram 语音聊天、Clubhouse、YouTube 直播、Twitch、B站直播...
Source #Voice #GitHub #Tool
Postman 桌面端现会自动在设备 agent 应用安装 skills 及 hook,引起争议。
- 还包括配置远端 MCP 服务以及安装 Postman CLI 等。
gh:postmanlabs/postman-app-support#14370
seealso: HackerNews:50354960
#Postman #LLM
AI泡沫是由特朗普错误发动,被黄仁勋、达里奥、奥特曼、马斯克错误利用的运动
由于对通用人工智能建设缺乏经验,急于求成,夸大了主观意志与Scaling Law的作用,没有经过认真的商业化验证,使得以高估值、刷跑分、浮夸风为主要标志的右倾盲动主义在硅谷严重泛滥开来。
在这场被称为“大炼模型”的历史时期中,各路资本与科技巨头纷纷大搞“万卡公社”,妄图依靠“人有多大胆,卡有多大产”的狂热,在短时间内跑步进入AGI的理想社会。
许多科技企业脱离业务实际,砸锅卖铁囤积B300,大搞“土法炼模”。这不仅造成了严重的算力浪费、电力紧张和“GPU饥荒”,更导致无数初创企业在“百模大战”中惨遭泡沫破裂的倒春寒,给全球科技界、投资界和美国人民带来了不可估量的损失。
如果在使用 Warp 并且也在其中配置过密钥信息的小伙伴,请注意吊销凭证,Warp 也被攻击了
https://fxtwitter.com/aiandcloud/status/2117824369766629787?a=NPZyLxw8fL9VMRgOksw&s=20
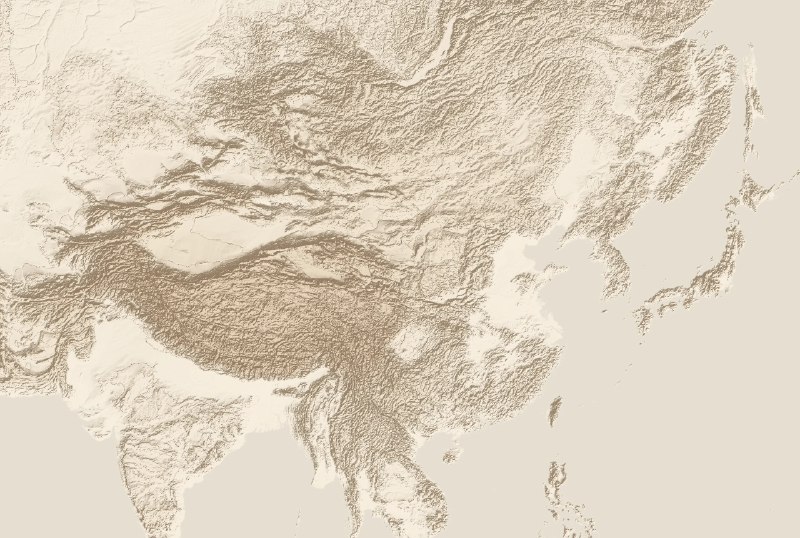
江山时序 · Chronicles of the Realm
https://deanchen.me/jiangshan-map/
https://github.com/DeanChensj/jiangshan-map一幅可以拖动时间、点城读史、追随古人足迹的中国历史交互舆图(公元前 403 年三家分晋 — 今)
一觉醒来发生了什么 11 月 04 日
#Daily
2026 年 11 月 4 日
🌍 资讯快读
1、“乌镇七子”
https://www.thepaper.cn/newsDetail_forward_34388431
2、上海首例!男子盗用 AI 算力,用 400 多万个账号薅积分牟利获刑
https://www.thepaper.cn/newsDetail_forward_34389477
3、贵州凯里失联半个月的 13 岁女孩已找回,母亲称其藏在同学家中玩手机
https://www.thepaper.cn/newsDetail_forward_34394112
4、俄确认俄美乌三方会谈 10 日至 11 日在阿布扎比举行
https://www.jiemian.com/article/15288713.html
5、一在校女生将其初中同学男扮女装带入宿舍,武汉工商学院通报
https://www.thepaper.cn/newsDetail_forward_34392888
👬 即刻镇小报
1、如何推进一件事情发生:
https://m.okjike.com/originalPosts/6ae84918320fd7e1b50efd2a
2、DeepSeek 口中的 Super Agent 是一个美好的技术幻梦
https://m.okjike.com/originalPosts/6ae5f9d7136b2761c65f5e0b
3、输入的信息并不一定都能消化,反而会让你产生焦虑,甚至空虚。
https://m.okjike.com/originalPosts/6ae92d6b1319d8834a337be3
4、好像你一直在解决问题,但其实你什么都没做。
https://m.okjike.com/originalPosts/6ae67710136b2761c66d75df
今日即刻镇小报内容来自 @西蓝发 @莫唯书 Mark @七帅 @有趣的自律大人 ,感谢以上即友的创作与分享。
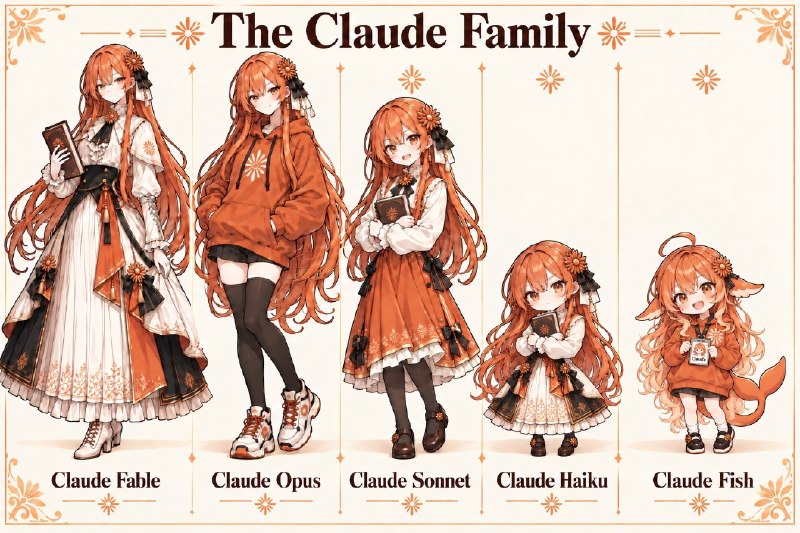
混进一条肥鱼(Claude Fish


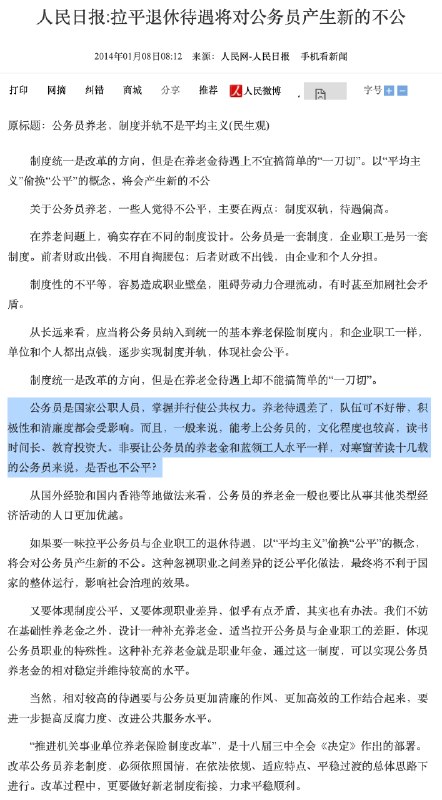
我们不妨在基础性养老金之外,设计一种补充养老金,适当拉开公务员与企业职工的差距,体现公务员职业的特殊性。这种补充养老金就是职业年金,通过这一制度,可以实现公务员养老金的相对稳定并维持较高的水平。
😅
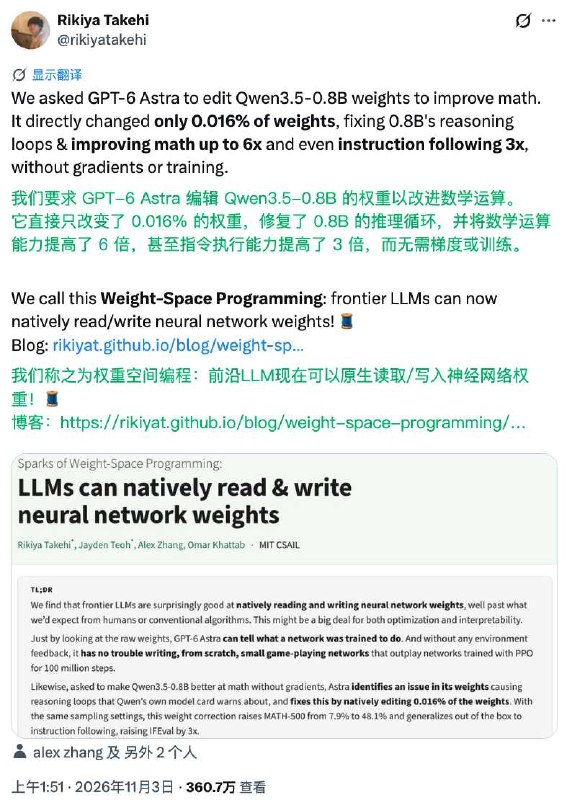
GPT-6 开始「手写」神经网络:把游戏规则变成权重,打砖块得分高出 20 倍
神经网络里动辄数百万、数亿个参数,过去主要靠训练算法反复调整。MIT 研究团队却发现,GPT-6 Astra 已经能直接分析、修改这些数字,甚至不用训练,就能从零写出一套神经网络。
研究人员把简化版打砖块游戏的规则、源代码和一套权重全为零的神经网络交给 GPT-6,让它自己填写参数。不提供训练数据,也不允许试玩。GPT-6 自己推算球的落点,把预测和移动挡板的逻辑写进网络权重。最终游戏得分达到 517.4,是同等结构、经过 5 亿步强化学习训练的模型的约 20 倍。不过,在另外两款游戏中,它没有超过训练 5 亿步的模型。
研究人员随后让 GPT-6 直接修改阿里 Qwen3.5-0.8B 的权重。它没有重新训练模型,只改动了 0.016% 的参数,就让 MATH-500 数学正确率从 7.9% 升至 48.1%,指令遵循成绩也提高了近 3 倍。
原来,Qwen 经常陷入思考死循环,反复推理却不给出答案。修改前,93% 的数学测试回答会耗尽 32768 个 Token;修改后降至 33.1%。GPT-6 相当于修好了妨碍模型正常答题的毛病。
但换成参数量仅 2.7 亿的 Gemma 3 270M,GPT-6 就没能明显提高数学成绩。这款更小的模型很少陷入死循环,主要问题是算术和推理本身就容易出错,没法靠修改少量权重轻易解决。
研究人员将这种直接读写参数的方法称为「权重空间编程」(Weight-Space Programming)。
信源
动察 Beating 频道 · 动察 Beating 交流群- 👍1
- 🤡1
HackerTube CN - V2EX 网友筛选的视频与博主清单
https://hackertube-cn.pages.dev/
https://github.com/caikaidev/hackertube-cn