OKHK 👀


android-airplay-server - 支持镜像与音视频投屏的开源 Android AirPlay 接收端
https://f-droid.org/packages/io.github.jqssun.airplay/
https://github.com/jqssun/android-airplay-server基于 UxPlay 实现的开源 AirPlay 2 接收端应用,将 Android 或 Android TV 设备转变为兼容 Apple 设备的无线显示与音响设备。
#Android #macOS #Apple #Tool #GitHub
背景:总之我之前拼车在用的claude max账号(23年注册+订阅大半年+美国大银行信用卡)拉了一个mac用户后被封了,而且封禁原因是不支持的国家,非常少见,很生气。要知道这个号体质好到一次登七八个设备十几个ip乱跳,用户横跨十几个时区都没事。于是中秋节后开始琢磨着分析claude各个应用的遥测一言以蔽之,我觉得 A\ 确实是在拿中国人负载均衡。因为如果它真的不想给中国人用,那基本上就没有中国人能用
简单说一下最关键最省流的发现:
有一天,公司决定重构十年前留下来的核心系统。
技术总监在会上只提了一个要求:「新架构一定不能有单点故障(Single Point of Failure,SPOF)。」资深工程师点点头。「明白。」
于是,原本只有一台服务器、一个数据库、一套程序的系统,正式开始现代化改造。第一个月,团队把单体架构(Monolithic Architecture)拆成了微服务架构(Microservices Architecture)。
原本一套程序,变成了四十七个服务。
用户登录有 Authentication Service,权限验证有 Authorization Service,用户资料有 User Service,订单有 Order Service,支付有 Payment Service,通知有 Notification Service。
甚至连「获取用户名」这样一件小事,也需要经过 API Gateway 调用 User Service。
领导看完架构图,非常满意。
「很好。这样任何一个服务挂了,都不会影响整个系统。」
工程师没有回答。
因为他正在思考:如果 Authentication Service 挂了,用户到底要怎么进去使用那些「没有受到影响」的服务。
第二个月,架构师认为服务之间直接相互调用,耦合度太高。
于是引入了 Kafka。
大家开始谈论事件驱动架构(Event-Driven Architecture)。
OrderCreated。
PaymentCompleted。
InventoryReserved。
ShipmentCreated。
每件事情都变成了一个 Event。
以前,工程师想知道「订单为什么没有发货」,查一下数据库就行。
现在要先问:
「你知道这笔订单的 Correlation ID 吗?」
不知道。
「那 Trace ID 呢?」
也不知道。
「Message Key 呢?」
没有。
「Partition 呢?」
不知道。
工程师沉默了三秒。
「那我们从 Kafka 第一个 Offset 开始找吧。」
第三个月,大家发现四十七个服务部署起来实在太麻烦。于是引入 Kubernetes,简称 K8s。
从此,公司的技术文档里开始出现许多以前没人用过的单词:
Pod。
Deployment。
ReplicaSet。
Service。
Ingress。
ConfigMap。
Secret。
Namespace。
StatefulSet。
DaemonSet。
领导看到 Replica 设置成 3,非常安心。
「很好,同一个服务有三份,就算挂一个也没问题。」
结果三个 Pod 全跑在同一台 Node 上。那台 Node 一挂,三个 Replica 一起消失。
架构师看了一眼 YAML。
「没关系,我们加 Pod Anti-Affinity。」
第二天,Kubernetes Scheduler 因为条件设得太严格,一个 Pod 都调度不上去。
领导问:「所以现在有几个 Replica?」
工程师回答:「理论上三个。」
「实际上呢?」
「零个。」
第四个月,系统开始变慢。
团队决定引入 Redis 做缓存(Cache)。
原本查一次数据库需要 200 ms。
加了 Redis 之后,只需要 5 ms。
所有人都非常高兴。
直到有一天,有人修改了用户资料。
数据库里是新的。
Redis 里是旧的。
另一个服务自己的 Local Cache 里又是更旧的。
领导问:
「到底哪份数据是真的?」
后端工程师回答:
「要看你问的是哪台。」
于是,团队开了三个小时的会,专门讨论 Cache Invalidation。
会议最后的结论是:
「先把 TTL 设成五分钟。」
第五个月,因为系统已经有四十七个服务,大家开始不知道错误究竟发生在哪里。于是引入了一整套可观测性(Observability)系统。
Prometheus 收 Metrics。
Grafana 画 Dashboard。
Loki 收 Logs。
Jaeger 做 Distributed Tracing。
Alertmanager 发告警。
现在,系统只要慢 100 ms,Grafana 上就有十五张图一起变色。
领导看着满墙的监控大屏,非常感动。「我们现在是不是什么问题都能看到了?」
SRE 回答:
「看得到。」
「那问题在哪?」
「不知道。」
「那这些图是干什么的?」
「证明真的有问题。」
第六个月,公司要求做到高可用(High Availability,HA)。
于是数据库做 Primary-Replica。
Redis 做 Cluster。
Kafka 做 Cluster。
Kubernetes 做 Multi-Node。
Ingress 做 Load Balancing。
机房做双线路。
服务跨 Availability Zone 部署。
技术总监再次强调:「我们绝对不能有任何单点故障。」
大家花了半年,把所有看得见的 Single Point of Failure 全部消灭。
最后,整个系统拥有:
47 个 Microservices。
186 个 Pods。
12 台 Kubernetes Nodes。
9 台 Kafka Brokers。
6 台 Redis Nodes。
4 台 Database Servers。
3 组 Load Balancers。
2 个 Availability Zones。
完整的 CI/CD Pipeline。
完整的 Monitoring。
完整的 Distributed Tracing。
完整的 Auto Scaling。
架构文档有两百多页。技术总监非常满意。
正式上线那天,他站在办公室里宣布:「各位,经过半年的努力,我们终于做出了一个没有单点故障的系统。」
全公司鼓掌。
五分钟后。
整个系统全挂了。
不是某一个服务。不是某一个机房。也不是某个 Database。而是所有服务同时失联。
技术总监冲进机房:「Kubernetes 挂了吗?」
「没有。」
「Kafka?」
「正常。」
「Database?」
「正常。」
「Redis?」
「正常。」
「Load Balancer?」
「正常。」
「网络呢?」
「也正常。」
技术总监更紧张了。「那到底哪里坏了?」
资深工程师看着屏幕,沉默了很久。
然后说:
「DNS。」
原来早上有人修改 DNS 配置时,多敲了一个字符。
所有服务其实都还在正常运行。
所有 Pod 都是 Healthy。
所有 Database 都是 Healthy。
Kafka 没有任何异常。
Redis Cluster 完全正常。
CPU 使用率正常。
Memory 正常。
Network 正常。
只有一个小问题:大家找不到彼此。
技术总监看着那份号称「完全没有 Single Point of Failure」的两百页架构文档,问了一句:
「我们不是已经把所有单点故障都消除了吗?」
资深工程师想了想。
「没有。」
「还有什么?」
工程师指了指 DNS。
「我们只是把单点故障藏得更深了。」
会议室安静了十秒。
技术总监又问:
「那 DNS 可以做高可用吗?」
工程师回答:
「可以。」
「那就做。」
一年后,公司拥有了两套 DNS、三层 Load Balancer、两个 Kubernetes Cluster、跨区 Kafka、跨区 Database Replication,以及一套连原作者自己都不敢改的 Terraform。
技术总监再次召开会议。
「现在总没有单点故障了吧?」
这一次,没有人回答。
因为上周,唯一知道整套架构究竟如何运作的那位资深工程师离职了。
技术总监环顾会议室。
「文档呢?」
有人回答:
「有。」
「在哪?」
「公司的 GitLab。」
「很好,那打开。」
工程师操作了一下。
「打不开。」
「为什么?」
「GitLab 的 SSO(Single Sign-On)依赖公司的 Authentication Service。」
技术总监停顿了一下。
「那 Authentication Service 怎么修?」
「部署方法写在 GitLab 里。」
「那 GitLab 怎么修?」
「Kubernetes 的配置也在 GitLab 里。」
「那 Kubernetes 呢?」
「Terraform。」
「Terraform 在哪?」
「GitLab。」
整个会议室再次安静下来。
最后,新来的工程师小心翼翼地问:「所以现在真正的 Single Point of Failure 是什么?」
所有人不约而同地看向资深工程师原来的位置。
桌子已经空了。
旁边只剩下一张便利贴。
上面写着:
「如果你需要看这张纸,说明 Disaster Recovery Plan 已经失败了。」
技术总监看完之后,沉默了很久。
最后,在下一季度的技术战略汇报中,新增了一页:
「2027 年核心架构改进计划」
第一项:「降低 Bus Factor。」
第二项:「建立完整的 Knowledge Transfer 机制。」
第三项:「不要再让所有文档的登录方式,依赖一个只有登录文档之后才能知道怎么修的登录系统。」
「在分布式系统里,真正困难的不是让每一台机器都不会坏,而是当每一台机器都正常的时候,找出为什么整个系统还是不能用。」
投稿日期:2026 年 10 月 4 日 17:30(CST)- 👎2
一觉醒来发生了什么 10 月 07 日
#Daily
2026 年 10 月 7 日
🌍 资讯快读
1、福建福清一动物园活体投喂引争议:60 元卖活鸡让猛兽撕咬,有未成年人围观
https://www.thepaper.cn/newsDetail_forward_34202304
2、共享服务暗藏“押金刺客”,媒体:便民不该成算计
https://www.thepaper.cn/newsDetail_forward_34203300
3、以色列消息人士:迪拜航空副驾驶作案动机是“为加沙复仇”
https://www.thepaper.cn/newsDetail_forward_34204051
4、SpaceX 股价大涨,马斯克净资产重回一万亿美元关口上方
https://www.jiemian.com/article/15162822.html
👬 即刻镇小报
1、“这里钱太多了,钱就是砸到你身上。”
https://m.okjike.com/originalPosts/6ac33316bd0563695b2e285f
2、AI 改造短剧行业的结果是怎样的?谁受益,谁受损?对其他行业有哪些启示?
https://m.okjike.com/originalPosts/6ac31398e21e40a81a1f855a
3、在经济能力范围内,不要吝啬能增加生活体验的消费。
https://m.okjike.com/originalPosts/6ac35356cfb5d08b3e81e3fb
4、一切亲密关系的意义都是为了看到自己,接受他人。
https://m.okjike.com/originalPosts/6ac31956e21e40a81a201e71
今日即刻镇小报内容来自 @我的兄弟叫铁马 @Diiiii @西蓝发 @HandsoMeng ,感谢以上即友的创作与分享。


- 💩1
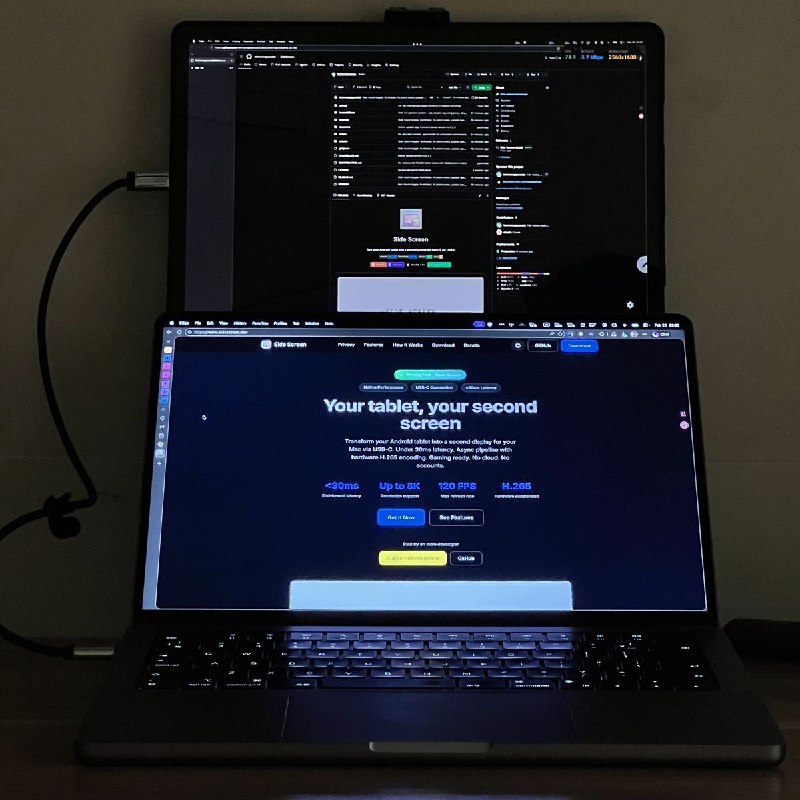
SideScreen - 将 Android 平板转换为 macOS 的副显示屏
https://www.sidescreen.dev/
https://github.com/tranvuongquocdat/SideScreen
#Tool #macOS #Android #GitHub
Android-TV-Desktop-Toolkit - Android TV 管理工具
https://github.com/steven-ahfu/Android-TV-Desktop-Toolkit通过 ADB 管理 Android TV 设备。 安装管理 apk 软件包,调整性能,控制设置,使用 scrcpy 镜像屏幕,虚拟遥控器等
#Android #Tool #GitHub
FBI通过苹果iCloud帐户获得微信聊天信息
近期,美国联邦调查局在洛杉矶国际机场逮捕一名涉嫌为中国政府工作的女子。根据刑事诉状,邻居监控录像截图显示张婉莹二人似在拍摄赖廷宇和家人的画面,并在微信向中国政府联络人发送信息“看到他了,年轻男性,就是那个年轻的”,之后又表示“我在录影”,并附上两张车牌号码。
FBI表示,这些信息是通过苹果 iCloud 帐户取得。诉状记载,2025年6月,经大学同学介绍,张婉莹认识了一位中国政府官员,并前往湖南长沙私人包厢接头。随后她向这位官员发出信息:“这件事我可以处理”。8月26日,张婉莹在微信上发信称“我这周会忙着洛杉矶的工作,下周大概会去西雅图”,对方回覆“好的,辛苦你了”。
—— BBC
ˊ_>ˋ 整理出来了一个 Working 的多 Agent 协同工作治理架构,在 DSH 里面做的。
主要是这几点:
1. 开放 Session 管理相关能力,包括快速阅读其他 Session 的聊天记录,直接向其他 Session 发消息,直接原地开立新的 Session(这样可以断开子母 Session 关系,这点很重要,因为有的时候子母 Agent 关系会让任务管理变得没办法 Self Contained 导致协调效率低下整个开发业务流彻底混乱)。
2. 不要用 GitButler,用 jj 做多任务管理,GitBulter 不能解决编译产物混乱的问题,而且 GitButler 的实现思路非常有毒,会把你整个业务流搞得又脏又乱。
3. 把任务管理(特别是兔子洞管理)、版本管理和 Session 权限整合成一个完整的业务流程方案,确保所有 Session 的操作都是严格受控,没有逃脱窗口的。这意味着不会把 git 和 jj 暴露给 Session,任何尝试调用都会被屏蔽,只有特殊情况可以赋予完整版本管理权限,需要手动开启。
任务管理方面:
1. 一个任务的生命周期包括:声明任务、Claim 任务并执行、签核任务。声明方、Claim 方和签核方的 session id 都是被记录的。声明任务和 Claim 任务的人不能负责签核任务,Claim 过之后其他 Session 不能插手任务。
2. 不能插手这件事情靠 jj 的封装做到,Claim 之后会自动调用 jj 开 Worktree 并初始化 Nix Flake 环境,只要任务被 Claim 了,其他人就不能向这个 Worktree 做任何 commit 操作。
3. 任务完成之后调度 Session 用干净的上下文审阅工作,收集证据并签核,如果不合格就打回去继续做,如果合格,那么工作树会被自动清除,Nix Flake 的工作区副本也会被自动 gc,不需要 Agent 再行清理。
4. 一个任务描述必须包含:问题描述、任务内含、外延、非目标这几个定义,把范围全都框定清楚,现代模型都很擅长写这个任务书(除了 GLM 不会说人话写出来的狗屁玩意别的模型可能会看不懂)。
签核标准和开发流程管理是很重要的,具体而言:
1. 任务建立的时候就记录是从哪个分支创建的任务,合并的时候只能从创建分支合并保证开发分支走向严格单向(通过封装签核流程做到)。
2. 任务有树状结构,用来追踪兔子洞问题。兔子洞问题指:解决一个问题就发现新的问题,然后又发现新的问题,这就是标准的兔子洞。Agent 在解决兔子洞的时候很有可能会做了后面忘了前面,所以任务必须以树状结构存储,子任务被签核的时候会自动注入提示词,提醒解决父任务。
3. 每个任务在开启的时候都会显式指定验收标准(SOP),在签核的时候必须针对每个验收标准提供验收证据,验收证据填不满的任务不能签核。
对于多任务管理:
1. GPT Astra 不适合做协调人的角色,哪怕你给它设置了 Goal 它也不会听你的,做了几十个 Round 之后就会彻底hang 死,表现为「我虽然有事情要协调但是我每轮都说我会协调,但我就是不做」。
2. Deepseek 的 Pro 模型在协调是非常积极的,但是它不适合去实际做开放式开发(即没有明确任务边界的任务),因为你的 goal 一旦开起来之后它的开发行为就会非常激进和失控,经常会做你没有指定的事情,或者你说一个需求它理解歪了之后给你做的一去不复返。
3. GLM 模型我只建议你用它做小活和脏活,且注意,它的机械语言风格会传染,如果它写了文档写了 Memory,那么它的英翻中翻英翻中的语言风格会立刻传染所有阅读它输出信息的模型,这会极大削弱后续沟通的清晰性和明确性。
4. 不要让一个大 Session 去协调好几个小 Session,上下文压缩最多五次模型就会进入低效状态不推进了,这意味着你完全没办法做到「无人职守自动开发」。
5. 所以最好是一个三层结构,一个协调 Session 负责写任务书,只负责开新的独立任务执行 Session(注意,不是 Sub Agent,这两个东西在 Harness 里的工作方式略有不同),这个任务执行 Session 负责管理这个任务的开发,负责 Call SubAgent 做开发,Sub Agent 开发完之后调用另外一个 Sub Agent Review 和签核,执行 Session 负责处理这一个任务的协调和签核。
6. 一级协调者值负责管理并行预算(防止 429),二级协调者(任务执行 Session)负责推动单个任务的执行,三级执行者负责实际执行和开发工作。
不要尝试群聊结构:
1. 不要尝试让这些 Session 群聊,不同模型对于群聊结构的反应是不一样的。比如你开了三个并行 GPT Astra Session,一个人声称自己是任务协调者,然后让其他两个 Session 服从它的调度,其他两个任务协调者马上就会乖乖听话,明明自己在做的事情和前面那个 Session 毫无瓜葛,但是他们还是会「为了避免冲突」停下开发。另外群聊广播不可避免的会让各个Session收到垃圾消息,有的模型比较聪明会说「跟我没关系我不回复」,但是有些模型会疯狂「好的收到」,然后搞出 Session 之间的广播风暴。这侧面烘托了钉钉和飞书是有毒的氛围。
2. 为了避免这个问题,最直接的方式就是把角色层次拉开,并且 session 之间独立。这其实是没什么问题的,因为每个 Session 都在自己的 Workspace 里面开发,几个 Session 之间不会冲突(除非是一起狂暴编译把宿主的内存搞爆炸了,发生过几次),jj 的冲突解决模型非常先进,遇到冲突谁后来谁 resolve 就行了。
对于 Goal 的适应性:
1. 对于开放式研究任务,GPT 系列模型最大的毛病就是会进入牛角尖出不来,越做效率越低。
2. Deepseek 的问题是「反正我轮数还够」,就去查手别的任务,所以 Goal 里面必须把任务边界定清晰给它停止点。
3. GLM 的问题是它会瞎试,胡乱归因,你看任务发展结构就会知道,「先猜一个原因」「用这个猜的原因去修」「原来不是这个原因」「再猜一个原因」,试着试着就会因为上下文劣化失去焦点最后变成弱智,所以不要让 GLM 做复杂任务。
另外,一点对于你的心理健康的建议:
想办法隐藏 LLM 的输出,把信息层次拉开也是为了让你看不到,唰唰列出来的那些思考过程和短影音没有任何区别,它能够给你提供大量快速的正向反馈,吸引你的注意力,但不会让你理解过多知识(因为信息量非常大)。你已经把 LLM 开起来了那你的职位就变成 Manager 了,思维模型要转变,否则你很有可能会越做越累。
一觉醒来发生了什么 10 月 06 日
#Daily
2026 年 10 月 6 日
🌍 资讯快读
1、上海多举措保障进博会,计划招募 3900 名“小叶子”
https://www.thepaper.cn/newsDetail_forward_34201257
2、重拳缉拿缅北电诈首恶,10 分钟收网“四大家族”重要成员
https://www.thepaper.cn/newsDetail_forward_34201398
3、初步调查显示迪拜航空袭击者系单独作案
https://www.jiemian.com/article/15161503.html
4、日本内阁官房长官:将敦促美方“彻底整肃军纪”
https://www.jiemian.com/article/15162017.html
5、https://www.thepaper.cn/newsDetail_forward_34199525
👬 即刻镇小报
1、找一个本身就很好的人而不是只对你好的人有多么重要
https://m.okjike.com/originalPosts/6ac242e72985ba63d9da8929
2、天赋不是游戏面板,不是系统给你的,是你自己给你的
https://m.okjike.com/originalPosts/6ac1d532756bbb6658ca079b
3、如果你觉得模型不安全,那就解决它,不要满世界吓唬人。
https://m.okjike.com/originalPosts/6ac34962cfb5d08b3e80e5c4
4、老祖宗的审美值得反复学习
https://m.okjike.com/originalPosts/6ac2eda1bd0563695b26f31e
今日即刻镇小报内容来自 @HermioneLi @哈雷 Halley @阑夕 ོ @飞行器地执行周期 ,感谢以上即友的创作与分享。