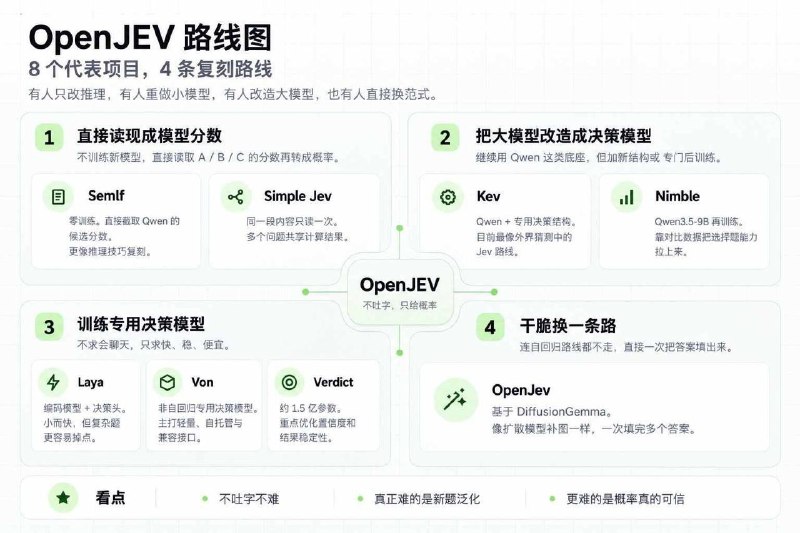
Jev 发布不到一周,开源社区已经复刻这种「不写答案、直接给概率」的模型:
1. SemIf 最简单,连模型都不用重新训练。它直接拿现成的 Qwen,在模型准备回答 A、B、C 时截住,不让它继续往下写,直接读取每个选项的分数,再换成概率。
2. Simple Jev 也用现成大模型,但进一步省掉重复计算。同一段材料只读一次,后面的多个问题共用这部分结果,再分别判断答案。作者也明确说,它复刻的是 Jev 的使用方式,准确率、速度和概率校准都没做到等价。
3. Laya 干脆不用会生成文字的大模型,换成更像传统分类器的编码模型。好处是小而快,短板也很明显。一次从 77 个选项里做选择时,Laya 准确率只有 42.5%,Jev 是 87.0%。
4. Von 走的也是专用决策模型路线。它只有约 4 亿参数,不生成文字,一次前向直接完成 Choice、Noul 和 Score,更像一个能读自然语言的新一代分类器。
5. Verdict 更小,只有约 1.5 亿参数。作者重点处理了两个问题:答错了还报很高的置信度,以及把选项顺序换一下,结果就跟着变。
6. Kev 选择保留大模型。它拿 Qwen 做底座,再加专门的决策结构,让同一份输入只读一次,多个问题各自算概率。第三方此前逆向 Jev 时,也推测它可能用了类似设计。
拿训练时没见过的新题测试,8B 版准确率约 78%,Jev 约 86%。差距主要在置信度,Kev 还有一些答错的题会给出 90% 以上把握。
7. Nimble 重点放在训练上。它用 Qwen3.5-9B,再准备一批「只改一个事实,正确答案就翻转」的数据做后训练。在 324 个没参与训练的测试样本里,Nimble 有 90.1% 选中了参考答案,Jev 是 93.2%。不过目前还不能保证模型「报 90% 就真的有 90% 正确」。
8. OpenJev 走得最远,直接换成 DiffusionGemma。它先把几个答案位置留空,再像扩散模型补图一样一次填出来。在 RTX PRO 6000 上,单请求中位延迟约 94ms。
Jev 这条路线看起来很好抄。真正拉开差距的还是准确率、泛化和概率校准。模型敢报 90%,这个 90% 到底有多可信,才是最难的部分。
动察 Beating 频道 · 动察 Beating 交流群
